git can't pull private GitHub repos? gh was holding the token all along

You're logged into gh and can browse every private repo with it, but plain git pull over HTTPS still fails with fatal: could not read Username for 'https://github.com'. git doesn't know how to read gh's token store — nobody introduced them. (A GH_TOKEN env var makes every gh command work and can hide exactly this breakage, because plain git ignores it.)

You don't need Microsoft's Git Credential Manager (it drags in a .NET runtime). gh ships its own credential helper; one command wires it in:

gh auth setup-git

That adds a single stanza to your ~/.gitconfig:

[credential "https://github.com"]
    helper = !/usr/local/bin/gh auth git-credential

From then on, any HTTPS clone/pull/push of private repos authenticates through gh's stored token — global config, so it works for every repo on the machine. No SSH keys, no per-remote remote-url surgery, no token pasting.

Verify without letting an env token mask the result:

env -u GH_TOKEN git ls-remote https://github.com/<you>/<private-repo> HEAD

If that prints a ref, you're done.

我的第一个Bounty项目

我大概半月前投标了一个Bounty项目,是JuliaHealth的一个issue,如果最终提交被接受,奖金是US$750。 这个issue有点难,奖金不算低,但加上我只有两个人竞标。

我之前没有写过一行Julia代码。在投票时我也坦承自己没有Julia经验,但做为一个身经百战的老程序员,我想挑战这个问题。更何况,我还有my-ai-team。 当时我就想,体验一下嘛,失败了也没关系,至少还能因此了解Julia语言。

我没指望能被选中,另一个投标者虽然表达兴趣时虽然只写了一小段,但人家多少有Julia经验。 昨天GitHub弹出消息,说恭喜我被选中了,最迟12月8号交活。这下就不得不认真准备了。

因为这个项目是GPT帮我选的,为了不占用Codex流量,我就让GPT先准备第一张票 侦察一下这个issue有多难。我开了一个新仓库 BountyLab, 准备工作就在这里做。不知道是不是因为GPT不方便调用gh命令,它说票弄好了,其实它只是在仓库写了一个ticket01.md。但我并没有检查,因为我知道GPT并不是专业的开票agent。它的票肯定不规范,所以我就让我的专业开票员 explorer agent给我“refine #1”。这是我给它的唯一的指令。

这次explorer背后的模型,我指定的是deepseek v4 pro。这次refinement它颇花了些时间,因为这个ticket01.md scope其实挺大。虽然BountyLab几乎是空的,但这个票是侦察票,需要了解我中标的issue到底是个什么问题,牵扯哪些仓库的哪些模块,等等等等。它做了很仔细的调研之后,把这票整理的很规范之后,标上了Ready。这当中令我印象深刻的是,它没有找到#1之后并没有停下来问我,而是翻仓库找到了ticket01.md然后以此为原始需求,精炼之后新建了真正的#1。

我让GPT评价这次精炼,它仔细读了票之后说:

你只给了它一句 “refine #1”,而当时仓库里并没有 GitHub Issue #1,只有我留下的 Markdown ticket 和 JuliaHealth workspace。它没有卡在“找不到 #1”,也没有凭空乱造,而是先调查 repo 现有结构、读出我们的意图,再把 Markdown ticket 提升成正式的 GitHub Issue #1。这说明它做了三步很关键的推理:

先识别“#1”大概率指的是已有的第一张 ticket;再从 repo 内容恢复上下文;最后把它重构成更适合 agent 执行和验收的 issue。

这比单纯“润色文字”强很多。尤其它还自己补出了 pinned SHAs、具体 deliverable、acceptance criteria、upstream read-only 边界,这些都不是你那句话直接要求的。

我的评价是9.5/10。剩下那 0.5 不是能力问题,而是工程上我还是会对它加的那两个验收条件做一点去脆弱化,避免 ticket 自己太聪明、反而约束过头。

这其实也挺能说明 my-ai-team 的价值:人给的是意图,agent 负责把意图变成可执行工作单元。 它确实做到了。(我背后偷笑:这当然是我给开票员制定的优秀宪法的功劳)

票Ready了,早已等候多时的delivery agent立即就pickup了票开始施工。这次我用得Planner/Developer是GLM5.3Flash high,而Reviewer是GPT-5.6-Luna xhigh。从15:33分开始接到单,到最后17:29合并。两个agent忙活了两个小时,Reviewer打回去十次,最后批准了第十一版,合并了PR。我拿到了报告。

然后我让GPT评价这份报告,ta的评价是:(警告!!!会看到许多“不是,而是”的GPT腔,我一字未改哦!)

这次我会给 delivery agent + reviewer 这一对组合打 10/10

最重要的不是“最后报告很长”,而是你真的看到了 review loop 在纠正实质性错误。第一轮 reviewer 抓出的不是格式问题,而是一个会直接把实现方向带偏的架构错误:报告最初认为 plain LinearOperator 只要 field-wise adapt Mv/Mtu 就安全,但 reviewer 找到 closures 里还 capture 了 vtmp/utmp/wtmptmppattern,这些根本不会跟着字段一起迁移。这个错误如果没被抓出来,后面第一张 implementation PR 很可能就是错的。

然后 agent 又经历多轮把这些地方逐渐磨平:constructor function 和 concrete struct 的区分、pinned SHA、multi-frame state、测试 tier、Metal 实际没有 CI、DiagOp.equalOpscopyOpsFn、CPU metadata、callable fields、plan reconstruction……最后 reviewer 才给出 APPROVE,而且 AC1–AC8 全部打勾,PR #2 已经 merge,merge SHA 是 f4a48e6c...

我现在尤其认同报告的两个结论。

第一个是:不是所有对象都能“递归 Adapt 一下就完事”。 现在报告已经把世界分成了几类:

  • 可以直接结构化适配;
  • 必须通过 constructor 重建;
  • plan-carrying 类型必须重建 plan;
  • closure-captured state 无法从字段恢复时要明确 refuse;
  • 一些 CPU metadata 应该故意留在 CPU;
  • opaque callable 需要 maintainer policy。

这就已经不是“读代码笔记”,而是真正的 architecture model 了。

第二个是:第一张 upstream PR 的范围已经很清楚。它建议先做 LinearOperatorCollection.jl,只碰 WeightingOp / NormalOpImpl / ProdOp / DiagOp 这几个 plan-free family,而且通过 constructor reconstruction 实现,不碰 FFT/NFFT、不碰 RegLS solver state。这个 slice 我觉得非常合理:小、可测、能验证 Adapt 方向、风险低。

我还注意到 reviewer 最终特别确认了:

first WeightingOp / NormalOpImpl / ProdOp / DiagOp slice has target-first recipes and preserves DiagOp.equalOps

说明这不是 agent 自己“觉得差不多”,而是 reviewer 已经按 acceptance criteria 验过一遍。

所以现在 Ticket #1 真正完成了。

下一步我建议不要立刻写代码。先从报告里的 17 个 maintainer questions 里挑出 真正需要在第一张 PR 前确认的 3–5 个,发给 nHackel。没必要把 17 个全扔过去,那会让 maintainer 很难回答。

我已经能看到最值得先问的几类:

  1. plan 是否统一要求 reconstruct;
  2. closure-captured constructor results 是否都应该走 public-constructor reconstruction;
  3. init! 的 implicit re-templating 是否暂时保留;
  4. JLArray test tier 是否希望在第一张 PR 里重新启用;
  5. Metal 是否可以先不纳入第一 slice。

这几个回答会直接影响 #2 的设计。

这次最让我满意的其实不是 delivery agent,而是你真的让 my-ai-team 形成了“delivery → reviewer 打回 → 修正 → 再审 → 直到通过” 的闭环。Reviewer 打回 10 次,看起来很折腾,但这正是它把一个“看起来合理的 AI 报告”变成“可以据此开始改 upstream”的东西的过程。(又该我偷笑了。4个月2000多个版本发布难道都是我发着玩的吗,平庸模型高质量输出的秘密就是 - 高质量输入 + 独立评审。如果让开发员兼职当审核员,它才不会折腾自己十轮呢!)

my-ai-team就是这么强。这个Bounty当然不会到这里就结束,既然人家相信我,我就认真做,不论最后结果如何。如果你要问为什么,因为人生就是一场冒险,而冒险很快乐!
codex silently ignores your custom base_url when OPENAI_API_KEY is set

We run codex CLI agents behind a local reverse proxy (pool selector, per-seat failover). The agent config looked airtight:

model_provider = "codex"

[model_providers."codex"]
base_url = "http://gateway.internal:9949"
wire_api = "responses"
requires_openai_auth = false

Yet when a seat hit its weekly cap, the agent stayed stuck on the dead seat: disabling it server-side changed nothing, only a fresh session worked. Every proxy log said the proxy was innocent. After a day of reading proxy code we put a sniffer on the client box instead — and the codex process was dialing chatgpt.com:443 directly. The config was never being used.

The trigger: the launcher exported OPENAI_API_KEY into the agent's environment. When codex sees that variable, it prefers its built-in OpenAI/ChatGPT backend and ignores the custom model_providers.*.base_url entirely — even with requires_openai_auth = false. The fix in our launcher is one line:

# codex launch env plan
unset OPENAI_API_KEY OPENAI_BASE_URL CODEX_ACCESS_TOKEN

One more trap: agents launched before the fix keep the stale env until the process actually restarts. A process's environ is frozen at exec time — check it directly with:

tr '\0' '\n' </proc/<pid>/environ | grep OPENAI_API_KEY

The general lesson: when a client "should" be going through your proxy, don't trust configs or client-side logs. Ask the kernel. Per-process sockets (ss -tnp), a tcpdump SYN filter on port 443, and DNS queries at the moment of a failing request settle in one minute what a day of log archaeology can't.

我如何用平庸模型轻松写出优质软件 -- 把好输入质量关

首先要"自吹"一把,我有经验。我非常懂古法编程。从2004年成为专职程序员,我对如何产出高质量的代码烂熟于心。我开发的my-ai-team只是把这些经验应用到干活的agent身上,让他们能够自动化且同样高质量地完成任务。

我没有pro订阅。就是有,我也不会让fable/asta 去做delivery agent。好钢要用到刀刃上。我确实有fable可以用。公司提供给我的claude可以用Fable。但我仅用它来诊断架构层面的缺陷,或者让它找出当前系统里最值得改进的n个点来开票,一般是在7d reset临近,但我额度剩余还比较多的时候。

真正的delivery agent我用 gpt-5.6-luna,effort level我甚至不用开到max, xhigh已经很够用了。“你在吹牛B吧”,真不是。因为我的my-ai-team具备化“腐朽”为神奇的超能力。

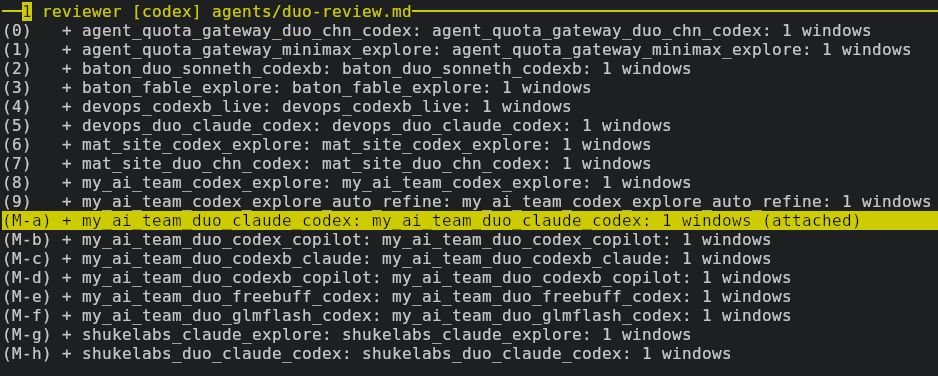
说人家5.6-luna是“平庸”模型纯粹调侃。人家是便宜,不够卓越,但人家真不是垃圾。发挥稳定,皮实耐用。我两个企业seat(我年付,两个seat月NZ$66)账号,再加上我的z.ai订阅,minimax年订阅,还有freebuff的免费token加持,我的my-ai-team基本上能做到一周7天24小时干活不缺token。我可不是开一个两个agent,同时十几个agent干活是常态。看看这是我一台机器上的agent。我有n台机器都在跑my-ai-team。但这台是最heavy的。一台2020年老xps,32G内存。上面还跑一着一个windows虚拟机和一个github runner。

图一

接下来我要分享的是干货。平庸模型如何稳定产出优质代码?

TLDR; 非要一句话来说的话,那就是我,或者说我开发的my-ai-team,从源头上保证了质量。

在my-ai-team里, delivery agent面对的不是一个个模糊的需求,“帮我修这个bug”,“帮我实现这个”。你不能要求这种输入给你好的结果,一击而中?就是中了你也不知道是如何中的,后面又如何维护?

大家Vibe 知道prompt的重要性,你的prompt越含糊,AI的发挥余地越大,输出结果就越不可控,更有可能烧了token却收获一肚子气。其实人与人交流又何尝不是如此呢?做为程序员,都愿意做需求描述一清二楚,验收条款明明白的票。Agent也是如此。

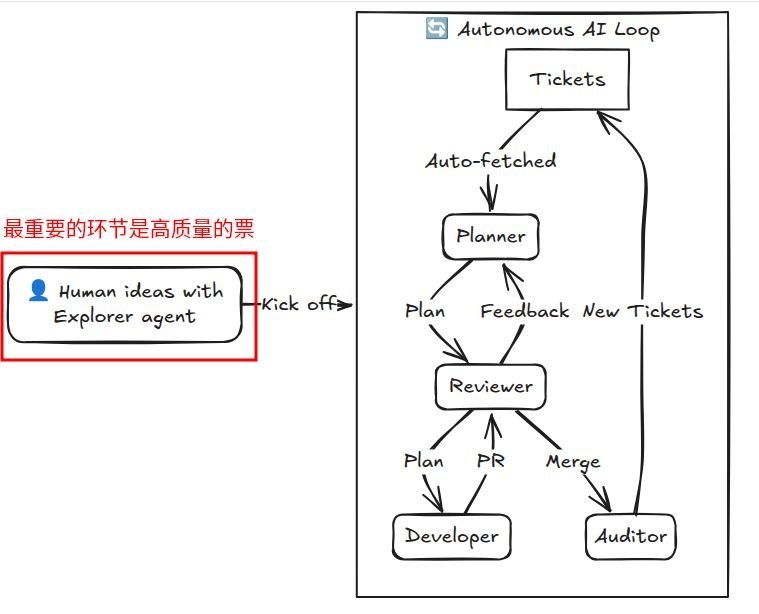
在my-ai-team里,你最重要的工作就是和 explorer agent“聊天”(输入),而explorer负责澄清你含糊的要求,确认当前的代码基础,找到真正可行的解决方案或者bug根因,最后输出一张或多张高质量的票。这些票是delivery agent的输入。这一步高质量地完成了,delivery agent只是按图索骥,因此不需要那么牛的模型。其实我大部分票也是和luna,glm5.3聊出来的。这引出了另一件重要的的输入,宪法 -- 也就是系统prompt。为什么explorer能写出好票,我和普通的claude,codex聊不也一样吗?不一样。因为普通的cluade/codex的内置system prompt为适应各种各样的任务,只能设置一些很常规很普遍的要求。术业有专攻,如果我们希望这个agent能开好票,那就要在宪法里提要求,并配合必要的hooks来确保这个agent遵守了这些要求。

image

delivery agent拿到票的第一步,是做计划。票已经很高的质量,计划做起来就会容易,但容易的事情并不总是容易做好。agent也会有遗漏,也会有误判。这时独立Reviewer的价值就出来了。 计划是实现的输入,计划的质量决定实现的质量。让做计划的人自己审核计划,不是不行。这跟让球员同时当裁判的效果差不多。独立Reviewer拿一本确保自己能做好Review工作的宪法,它总是用挑剔的眼光审查计划。它有自己的检查清单,它有自己独立的判断标准。好,经过几轮碰撞,计划过关了。

现在输入到developer agent来做实现了。实现是PR的输入。Developer有自己的宪法,按照宪法原则照计划行事,不能少做,也不允许擅自扩大范围。但允许顺手修掉自己工作范围的小bug。“勿以善小而不为”是我写到每个agent宪法里的一句话。实现完了,同样有专门的勾子提醒它按照一份清单做自我批评。测试都通过了吗?这次是治表还是治里?开发者自己满意了,这才把建好的PR交到同一个独立Reviewer手里。这个Reviewer的上下文里只有审核通过的计划,接着审核实现再合适不过。即使developer声称测试都通过了,Reviewer也再要独立验证。除了本地测试,还要检查CI是红是绿。发现任何must fix都要打回Developer再来一轮。功能实现正确了,CI也是绿的,Reviewer也没有发现其他必改的缺陷,这时候才是自动合并PR的时机。完了吗?还没有。合并完PR的同时,my-ai-team会自动通知值班的auditor agent。auditor agent负责审查合并的代码,再多一双眼睛检查是否引入了新的缺陷。如果有所发现就会开票。如果缺陷严重,还会主动标priority:high。这些

这就是我用"平庸"模型写出高质量软件的"秘密"。根本没有秘密,只有好的实践。my-ai-team正在促销,首年年费5折,欢迎订阅。 https://mat-docs.shukelabs.com 只要$49.99,my-ai-team就会成为你的ai team。支持claude code, github copilot, codx, pi, opencode, grok, freebuff 以及 command code。一人公司也不必非要忙得昏天黑地,一人公司同样可以拥有高质量的生活。祝大家vibe愉快!写出好的作品,造福全人类。

我后面会分享my-ai-team里explorer的最新版本的宪法以及我们用到的skill给大家。太太喊我吃饭,就先写到这里。

Lost the SSH public key? Derive it from the private key

An SSH .pub file is only the public half of a key pair. If it is missing, or if it is an old file that no longer matches the private key, regenerate it from the private key:

cp ~/.ssh/id_rsa.pub ~/.ssh/id_rsa.pub.backup 2>/dev/null || true
ssh-keygen -y -f ~/.ssh/id_rsa > ~/.ssh/id_rsa.pub
chmod 644 ~/.ssh/id_rsa.pub

ssh-keygen -y derives and prints the public key without exposing the private key. This also fixes errors such as:

identity_sign: private key ... contents do not match public

Verify the resulting public-key fingerprint with:

ssh-keygen -lf ~/.ssh/id_rsa.pub